在之前 10 月 6 号那篇近况报告的结尾,我曾经写过一段跑题的脑洞:
“比如通过 Cerebras 提供给 OpenAI 的 UltraFast 模型服务(跑在 CS-3 的 WSE-3 平台上),利用开源实现的部署 token speed,来计算在不同稀疏度下 OpenAI 前沿模型的大小……反正我就会去思考这些不明所以的内容,也没什么实际意义,纯当挑战最强大脑当娱乐。”
当时只是顺手写了一笔,后来我自己回想起来,觉得这个思路还挺有意思的。今天趁着把手头那堆资料和测算备忘录翻出来,把当时这个莫名其妙的推导完整记下来。
反正写博客就是记录我平时到底在折腾些什么,省得显得我天天无所事事(笑)。
契机:荒诞的三流投资播客
事情的起因非常抽象。
大概是去年还是什么时候,我偶然听到了一个看着就像三四线水平的投资播客《苔藓之火》(出处在这里:Spotify / YouTube,有兴趣可以去围观一下有多离谱)。那一期节目莫名其妙邀请了一个叫王铁震的人,title 挂着“前 Hugging Face 的 APAC ecosystem head”(亚太生态负责人)。
说实话,我完全看不懂这个所谓的“APAC ecosystem head”到底是个什么鬼东西反正看着不像什么研发岗。查了一下科技圈这种头衔大多是搞开发者关系、办黑客松、拉人上平台的生态商务岗,既不负责底层集群分布式训练,也不用管显存带宽和通信算子。但他在节目里大肆吹嘘,信誓旦言地讲:
“国内那些 1.6T、1.8T 的模型根本不算什么,国外早就把 Flash 级别的模型做到了 5T,至于 Pro 级别的模型,可能都有 10T 甚至 15T……”
当时在耳机里听到这段,我第一反应就是:去你妈的吧,怎么可能?
只要稍微算一算硬件常识就知道有多离谱。10T 到 15T 的模型,在目前的半导体物理和工程体系下,哪怕是推理在线 Serving,硬件带宽和互联通信成本都会直接炸穿,根本没有商业落地的可能。
但我这人有个毛病,就是听到这种离谱的暴论之后,心里会极其不爽,非常想用严谨的物理和工程方法把它给反驳掉。
于是我就陷入了一个执念:在闭源大厂把所有参数和架构都封锁得死死的今天,我们到底能不能从外部推测出前沿模型的真实体量?
为什么 GPU 测不出来?
我最开始的思路非常朴素:去找 NVIDIA DGX 系统的数据,结合线上模型的 API 输出速度来反推,之前 Semi Analysis 分析 GPT-4o 的时候就是用的这样的方法。
但稍微推一下就会发现,普通公有云 API 完全是个深不可测的“黑盒”: 硬件代际不确定:你调的 API 背后到底跑在什么上?是 A100、H100,还是 B200、B300?根本不知道。 切分和拓扑未知:Tensor 并行、流水线并行切了多少张卡?跨机通信的开销占了多少? 动态 Batch 的灾难:公有云为了榨取利润,全都在高并发下跑 Continuous Batching。你在客户端测出来的 Token 速度(TPS),里面混杂了排队等待、并发调度和算力争抢。你根本分不清到底是因为模型太大跑得慢,还是因为当前有几千个人在跟你抢资源。
变量太多了,方程完全没办法收敛。从普通 GPU 倒推直接成了一条死胡同。
突破口:Cerebras CS-3
直到 OpenAI 联手 Cerebras 推出了面向代码补全的 UltraFast 模型服务(包括 GPT-5.6 Sol 以及后来的 Astra),这个谜题终于裂开了一条缝。
为什么 Cerebras 能当测谎仪?因为它的硬件逻辑和普通 GPU 集群截然相反:
- 硬件直接锁死:明确跑在 CS-3 系统的 WSE-3(晶圆级引擎) 上;
- 全晶圆超大带宽:WSE-3 是一整张巨大的芯片,上面集成了 44GB 的片上 SRAM,聚合内存带宽达到了恐怖的 21 PB/s;
- Weight Streaming 与低 Batch 特性:Cerebras 的架构是把模型权重通过极高速总线流式送进晶圆,每个 Token 生成几乎天然运行在 Batch=1(或者极低 Batch) 的状态下。
这个特性太关键了。这意味着在 WSE-3 平台上,多用户并发带来的排队和延迟折损极其微弱。它的单流输出速度,几乎是赤裸裸地暴露了“硬件物理带宽 vs 单步激活参数量”的直接兑换关系!
GPU 上那些乱七八糟的调度噪音,全被这块大晶圆给物理过滤掉了。
找坐标系:开源模型的速度对照
为了倒推未知模型,首先要找到已知的基准。
我翻遍了 Cerebras 过去公开的技术博客,以及他们在 2026 年向美国 SEC 提交的上市披露文件(里面有一组 4 月 14 日的推理基准数据),把各个开源模型在 CS-3 上的实际输出速度整理成了一张对照表:
| 模型 | 总参数 / 激活参数 | 架构类型 | Cerebras 输出速度 | 说明 |
|---|---|---|---|---|
| Llama 3.3 70B | 70B / 70B | Dense | ~2,100 - 2,457 tok/s | 包含推测解码与算子优化 |
| Llama 3.1 405B | 405B / 405B | Dense | ~969 tok/s | 1K 上下文实测(100K 时约 539) |
| GPT-OSS 120B | 117B / 5.13B | MoE | ~3,000 tok/s | 首发高速部署 |
| Qwen3-235B | 235B / 22B | MoE | >1,400 tok/s | FP8 精度部署 |
| GLM-4.7 | ~358B / 32B | MoE | ~1,000 tok/s | 文章称部分任务最高 1,700 |
| Kimi K2.6 | ~1T / 32B | MoE | ~981 tok/s | 企业端点,4-bit 存储,约 20 台 CS-3 |
| Sol UltraFast | ? / ? | 确认跑在 CS-3 | 最高 ~750 tok/s | 官方披露技术报告 |
| Astra UltraFast | ? / ? | 假设跑在 CS-3 | 官方公布 ~300 tok/s | DevDay 说明 / 第三方实测 |
这张表里有两个非常显眼的对比点:
- 405B 全激活的 Dense 模型,速度能跑将近 1,000 tok/s。
- 而那个号称最强的前沿模型,速度居然掉到了 300 tok/s(最慢 253 tok/s,最快 436 tok/s)。
如果它是 Dense 稠密模型,要从 405B 的 ~969 tok/s 掉到 300 tok/s,参数量得硬堆到 1.2T 甚至更高。但全世界都知道,没有任何正常团队会去训一个 1.2T+ 的全激活稠密模型——那不仅训练要命,推理带宽更是自杀。
所以它百分之百是一个 MoE(混合专家)架构。
算一算:经验常数与激活参数
有了上面那几个大型 MoE 的数据,就会发现一个非常有意思的经验规律:
在 Qwen3-235B(激活 22B)、GLM-4.7(激活 32B)、Kimi K2.6(激活 32B)这三个不同机构训练的 MoE 模型上,它们的有效激活参数 × 输出速度惊人地一致:
- $22\text{B} \times 1,400 \approx 30,800$
- $32\text{B} \times 1,000 \approx 32,000$
- $32\text{B} \times 981 \approx 31,392$
这三个数字的算术平均值大约是 $C \approx 31,400$。
也就是说,在 CS-3 现有的通信和流式框架下,MoE 的推理速度大致遵循这样一个经验反比: $$\text{TPS} \approx \frac{31{,}400}{\text{Active Parameters (B)}}$$
直接把官方公布的 300 tok/s 代进去算: $$\text{Active} \approx \frac{31{,}400}{300} \approx \mathbf{104.7B}$$
即便把 GPT-OSS 那个带固定延迟项的四点线性回归模型也算进来($T_{ms} = 0.191668 + 0.0252421 \times \text{Active}$),解出来的激活参数大概是 124.5B。
换言之,它的单步有效激活参数,被极其稳定地锁定在了 105B ~ 125B 这一区间。
而对于另一个确认跑在 CS-3 上的 Sol UltraFast(750 tok/s),同样代入公式: $$\text{Active} \approx \frac{31{,}400}{750} \approx \mathbf{41.9B}$$ 正好落在 40B~60B 的区间,非常符合轻量快速代码生成模型的定位。
从激活参数推导总参数:怎么可能 10T !
知道单步激活了 105B ~ 125B 之后,总参数就全看它的**整体激活率(稀疏度 $r$)**了: $$\text{Total Parameters} = \frac{\text{Active}}{r}$$
我们直接带入不同的激活率来看看对应的总参数分布:
| 假设整体激活率 $r$ | Active = 105B 时总参 | Active = 125B 时总参 | 状态说明 |
|---|---|---|---|
| 5.0% | 2.10T | 2.50T | 行业标准细粒度区间 |
| 4.0% | 2.63T | 3.13T | 黄金稀疏度中心 |
| 3.0% | 3.50T | 4.17T | 激进细粒度假设 |
| 2.5% | 4.20T | 5.00T | 极端边界 |
| 2.0% | 5.25T | 6.25T | 极度不稳定边界 |
根据目前大模型架构设计的共识,细粒度 MoE(比如 DeepSeek-V2/V3、Kimi 等)在保证能力不塌缩的前提下,最优的黄金激活率大多收敛在 4% ~ 6% 之间。
把这个区间套进去,模型总参数量非常自然地落在了 2T 到 3T 左右(极值不超 4T)。
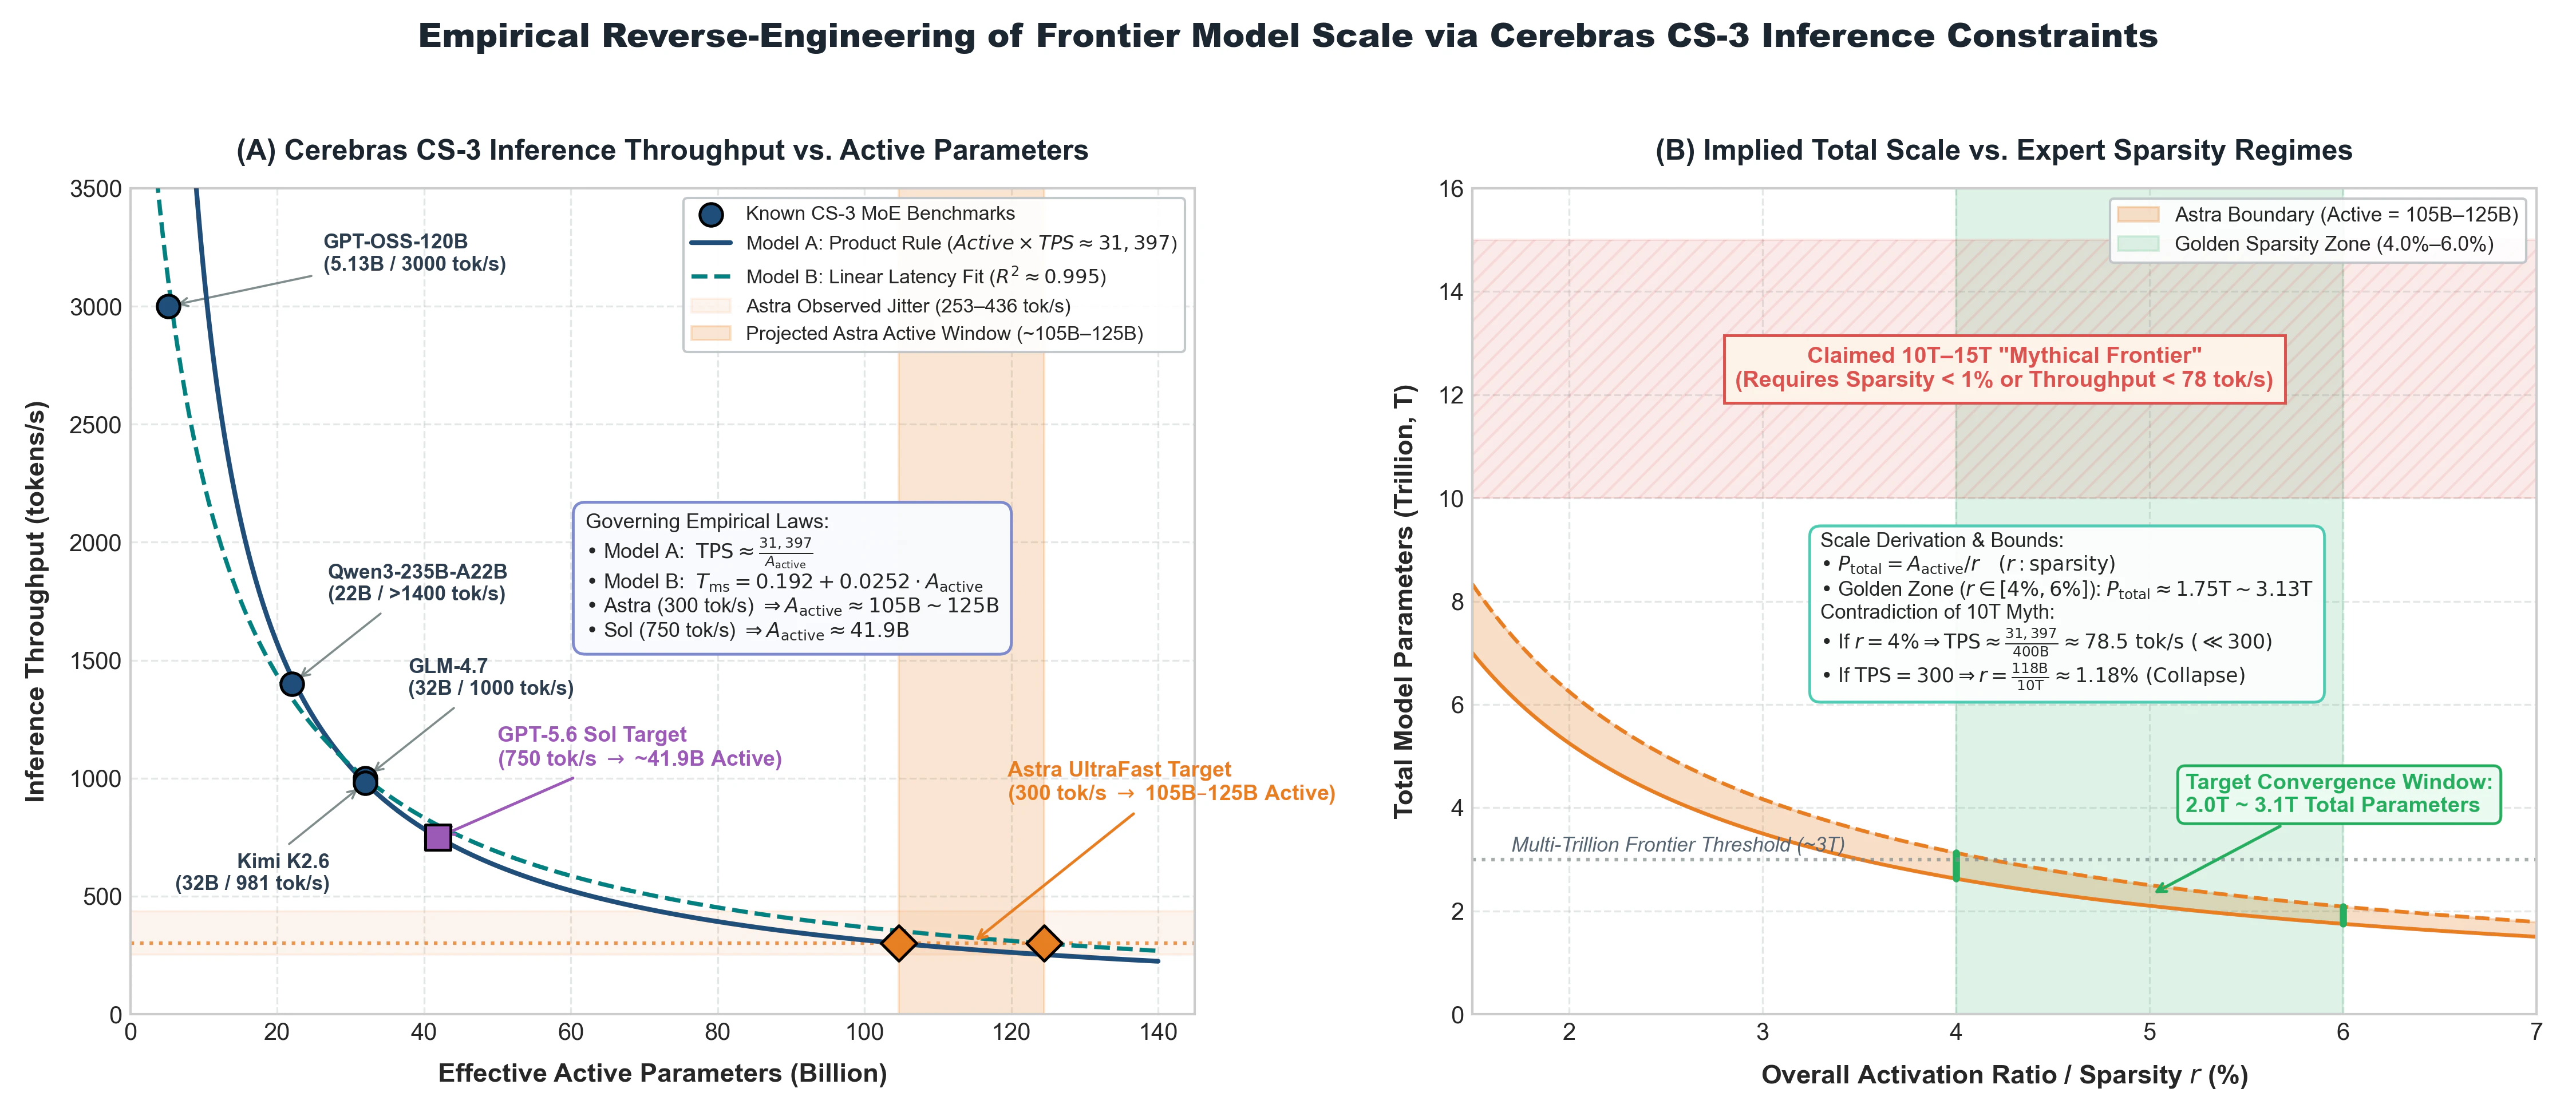
图 (A) 展示了 CS-3 吞吐量与有效激活参数的经验拟合曲线及 Astra / Sol 的拦截窗口;图 (B) 展示了不同稀疏度下的总参数展开,墨绿色为 2T~3T 黄金收敛区,上方红色虚影即为脱离物理常识的“10T 神话区”。
现在我们做个反证法,回头去打那个王先生的脸:
假如这个模型真的像王铁震吹的那样,有 10T 参数:
- 如果它保持正常的 4% 激活率,那单步激活参数就是 $10\text{T} \times 4% = \mathbf{400B}$。代入经验公式,它的速度只能跑到 $31,400 / 400 \approx \mathbf{78.5\text{ tok/s}}$!根本不可能跑出 300 甚至实测 436 的速度。
- 如果非要让 10T 的模型跑出 300 tok/s(激活 105B~125B),它的激活率就必须压到 1% 甚至 0.7%。这意味着从几千个微型专家里只选几个,路由死锁、专家容量崩塌,模型智商早就废了。
所以,无论怎么算,所谓的 10T、15T 纯粹就是不写代码、不算带宽的人在扯淡。
小插曲之说漏嘴:Hot Chips 2026
巧合的是,今天上午我上课摸鱼的时候,翻到了 Cerebras 在 Hot Chips 2026 上的官方技术报告(Ultrafast Frontier Inference: Cerebras Deep Dive at Hot Chips 2026)。
报告里在展望下一代 CS-5 系统时,有一页幻灯片莫名其妙提了一句原话:
“for the largest foundation model including multi trillion parameter models such as Kimi and GPT 5.6 sol, CS-5 targets up to 5000 output tokens per second per user…”
神了,你Cerebras把Openai给卖了:
- 直接把 Kimi 和 GPT 5.6 Sol 并列在一起;
- 明确把它们定义为 “multi trillion parameter models”(多万亿参数模型)。
这将证明:第一,它的体量确实就是 multi-trillion(2T~3T 这个级别可能更大);第二,能跟 Kimi(公认的万亿 MoE)放在同一个吞吐模型下对比,证明它在调度和拓扑上大概率是 MoE 架构同时因为是类比这个Multi的定义也在2.6的1T左或者右。 当然,卖了,但没有完全卖,他只是提了一嘴 multi-trillion parameter model。如果是10T以上,我估计他绝对会拿出来单讲。
局限性(仅供娱乐)
当然,严谨一点讲,我这套推导依然有不少未经验证的边界和局限性:
- Astra 是否 100% 跑在 CS-3 上? Sol 跑在 CS-3 上是官方确认的,但 Astra 到底是不是纯 CS-3,官方公告并没有写死芯片型号。第三方测试在 Bedrock 环境下测出中位 406 tok/s、最高 436 tok/s,不同环境不能简单混为一谈。
- 投机解码(Speculative Decoding)的干扰: 实测中 TPS 在 253 到 436 之间剧烈波动(对应生成间隔 3.95ms 到 2.29ms),这明显就是投机解码的特征——在缩进、固定语法结构时疯狂命中飙到 436,在复杂逻辑分支回滚退回时跌到 253。好在开源基准在 Cerebras 上大多也带着投机解码,同口径对比下误差能相互抵消一部分。但是投机解码这个东西优化了上限和下限太离谱了很难说有多精确。
- 荒谬的高昂定价: 这个服务的公开定价极度昂贵,每百万 Token 输出高达 300 美元(也就是千字 0.3 美元,相当于 1 美元买 1 tok/s)。这种奢侈的定价既可以说明它消耗的资源极度夸张也可以论证为它的利润率非常恐怖,所以真的搞一个 5T 6T 的 MoE 模型,还真是有可能在这个定价里面存在,所以不能排除,当然,如果有10T我只能确信OpenAI内部有什么天顶星科技。但是同时它有它的普通服务,在 NVIDIA 显卡上面的定价又是相对来说非常便宜的(只是相对,你要单看它的价格也是贵得离谱),所以完全就可以排除那些非常恐怖的大小,比如说10T。
- 架构未解项: 比如 SemiAnalysis 之前提过的 Loop Transformer(深度方向循环利用层权重),虽然目前开源界最大的实验也就 90B 左右,但如果有用,参数甚至会更小。至于 MoE 路由里的 Top-K 选路和共享专家(Shared Expert)具体是怎么配比的,这也是个未解之谜,没有人在 CS-3 集群上面跑过这个玩意儿,同时它的性能占用也是个未解之谜。。
- 稀疏率: DeepSeek V4.1 Flash 这个模型的稀疏率在 Prefill 阶段,激活参数是 8B,稀疏率达到了惊人的 1.45%(8B 比 552B)。在 Decode 阶段,它的稀疏率是 2.9%(16B 比 552B)。当然,这是纯粹的激活参数。如果我们算上 DeepSeek 的天鼎星科技 Engram 的 196B 参数,那理论参数的稀疏率将达到:在 Prefill 阶段 1.07%(8B 比 748B),在 Decode 阶段稀疏率能达到 2.14%(16B 比 748B)。 当然,我们比较的 Token Speed 本质上只是 Decode 阶段,并且 Ngram 理论上是不占用或者说不太占用性能的。且其他的模型并没有使用 Engram,我们也不知道 Engram 能否真正意义上算进模型参数里,因为 Engram 本质上并不能算参数。但即使是使用 Engram 的Decode稀疏率 2.14% 做一个不严谨比较:105B÷2.14%≈4.9T 125B÷2.14%≈5.8T,它依然比 10T 还差一个数量级。 (这一条是后面加的,DeepSeek 真的是有什么都开源)
结语
反正推导下来大概就是这样。算完之后,虽然不能证明一个准确的数字:
哪怕是最前沿、能在千禧年数学竞赛拿奖的所谓超级模型,体量也基本就收敛在 2T 到 3T 左右当然这是一个可能的数字,但是它绝对不可能是10T。
现在的技术路线早就不是早期那种野蛮比拼参数大小、比谁拳头硬的时代了。大模型的真正壁垒在于后训练(Post-Training)、合成数据飞轮以及测试期推理计算(Inference-time Search)。一个调优极佳的 27B 模型在特定领域完全能干翻早期的 GPT-4o。
更大的模型之所以还有价值,不是为了去凑那些迎合资本市场的万亿虚荣指标,而是因为更大的参数提供了更辽阔的表征探索空间(Map)与后训练泛化能力。
虽然算到最后还有一些不严谨的地方,纯当挑战最强大脑当娱乐罢。
但……难道不酷吗? 在一堵被大厂保密协议和公关辞令严密封锁的高墙上,靠着几个开源基准、发布会说漏嘴的 PPT 和基础的物理定律,硬生生把这个被神话的庞然大物扒了个底朝天。
反正绝对不可能是 10T。就这样罢。
参考资料与数据出处
整理这篇推导时用到的公开基准、技术博客与研究出处,留在这里备查:
- Cerebras Hot Chips 2026 报告(CS-5 目标及多万亿模型表述):Ultrafast Frontier Inference: Cerebras Deep Dive at Hot Chips 2026
- Cerebras 2026 上市披露(SEC S-1 / 2026-04-14 批次推理基准):SEC 披露文件
- GPT-5.6 Sol 部署说明(750 tok/s 与晶圆流式执行方式):How Cerebras Serves GPT-5.6 Sol
- OpenAI DevDay 2026(Astra UltraFast 300 tok/s 发布说明):DevDay 2026 Recap
- Foxl 第三方测速(Astra UltraFast 速度分布):Astra UltraFast Benchmark
- Kimi K2.6 部署(981 tok/s、4-bit 存储与推测解码):Cerebras Kimi K2 Enterprise
- VentureBeat 采访(Kimi K2.6 在约 20 台 CS-3 上的部署):VentureBeat 报道
- Qwen3-235B-A22B(>1,400 tok/s 与 FP8):Qwen3-235B on Cerebras
- GLM-4.7 部署记录与速度范围:GLM-4.7 on Cerebras
- GPT-OSS-120B 部署记录(3,000 tok/s):GPT-OSS-120B on Cerebras
- Llama 3.1 405B(969 tok/s 实测与长上下文对照):Llama 405B Inference
- Cerebras 推测解码生产升级公告(2024-10-24):Cerebras Inference 3x Faster
- MoE 最优稀疏度 Scaling Law(ICML 2025,Abnar 等):Optimal Sparsity in Mixture-of-Experts
- Cerebras CS-3 / WSE-3 Datasheet 规格白皮书:Cerebras Hardware Datasheet


